
Teste modelos reais nos seus prompts e escolha o menor custo que mantém a qualidade da sua automação.
Descubra qual modelo entrega a melhor combinação de qualidade, custo e velocidade para cada automação dos seus clientes — testes reais via OpenRouter, comparando custo, latência e qualidade lado a lado, com suporte a texto, imagem, PDF e documentos. Nenhum cadastro individual de chave de provedor. Pensado para agências que gerenciam automações de vários clientes.
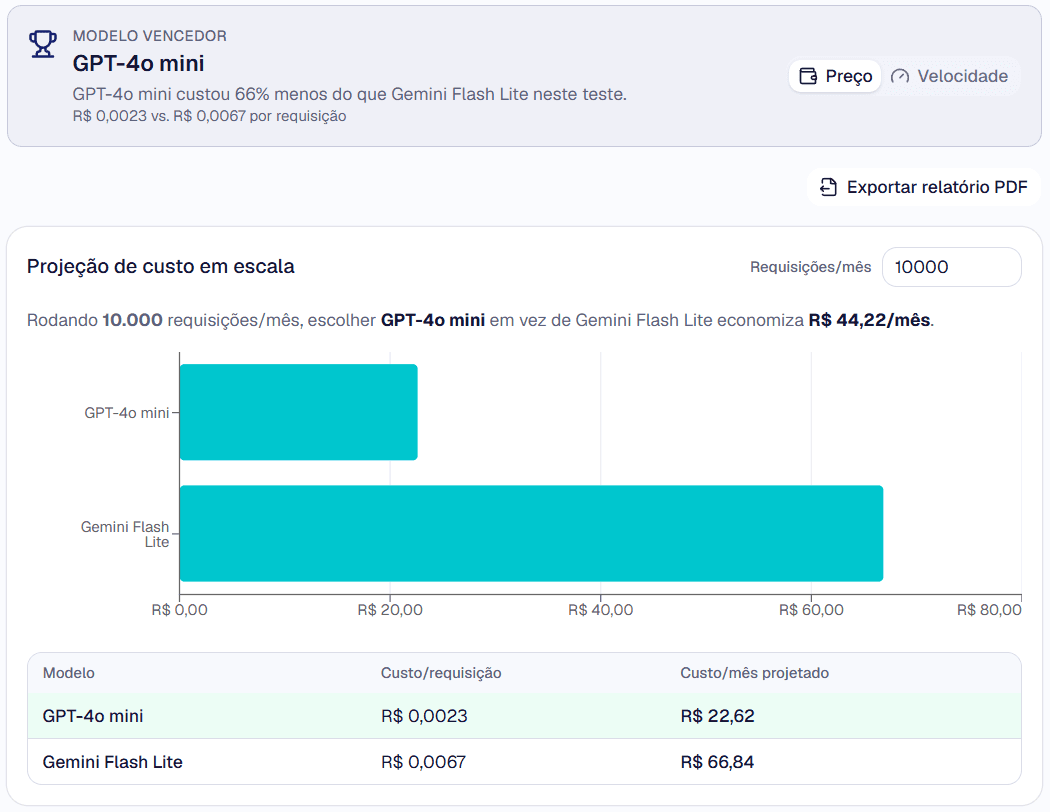
gpt-4o · OpenAI
- Custo por chamada
- R$ 0,18
- Latência média
- 2.4s
claude-3-5-sonnet · Anthropic
- Custo por chamada
- R$ 0,06
- Latência média
- 850ms
deepseek-v3.2 · DeepSeek
- Custo por chamada
- R$ 0,03
- Latência média
- 610ms
Como funciona
Não é só uma comparação única — o OtimizaIA mantém um histórico reutilizável.
Crie um projeto para seu cliente
Organize benchmarks e histórico por cliente — cada projeto fica isolado dos demais.
Salve um benchmark com prompts e casos reais
Comece com um caso de teste só. Adiciona documentos, imagens e mais casos quando quiser.
Compare modelos via OpenRouter
Execução real, sem cadastrar nenhuma chave de API — custo, latência e qualidade lado a lado.
Acompanhe custo, qualidade e regressões
Reexecute o mesmo benchmark quando mudar um prompt ou modelo e compare com a versão anterior.
Escolha um modelo pra ver o exemplo
Cliente recebeu pedido com embalagem violada e solicita reembolso total.
Números ilustrativos, não são o resultado do seu prompt nem custo real — teste de verdade no plano Free.
Diferenciais
Calculadora de economia
Hipóteses editáveis, cálculo instantâneo — sem chamar o OpenRouter, sem consumir crédito.
Hipótese conservadora e editável — não é uma promessa de resultado.
- Gasto atual estimado
- R$ 2.500,00
- Parcela otimizável
- R$ 1.875,00
- Economia mensal estimada
- R$ 656,25
- Economia anual estimada
- R$ 7.875,00
- Gasto projetado após otimização
- R$ 1.843,75
Estimativa; valide com um teste real dos seus prompts.
Para quem é
Pensado pra quem decide qual modelo usar em produção — e precisa justificar essa decisão.
O que é um benchmark persistente
Um benchmark persistente é um conjunto salvo de prompts, documentos, imagens, critérios e modelos que pode ser executado novamente sempre que você mudar um prompt, modelo ou workflow. Assim, você compara a nova versão com a anterior e identifica regressões antes de publicar.
Benchmark: “Atendimento — Cliente X”
- 25 casos reais anonimizados
- Modelo atual: Gemini Flash
- Modelo candidato: Claude Haiku
- Qualidade mínima: 8/10
- Custo máximo: R$0,05 por execução
OtimizaIA vs PromptFoo
A alternativa ao PromptFoo com interface gráfica, sem YAML e sem precisar programar — veja a diferença lado a lado.
| PromptFoo | OtimizaIA | |
|---|---|---|
| Precisa saber programar? | Sim — configura tudo em YAML e roda por linha de comando | Não — interface visual, clique e pronto |
| Interface gráfica, sem terminal? | Não — é uma ferramenta de CLI | Sim — nada de instalar nada no seu computador |
| Precisa de chaves de API próprias dos provedores? | Sim — você cadastra e paga cada provedor separado | Não — já vem com créditos inclusos na assinatura |
| Preço em reais, sem surpresa na fatura? | Não — é grátis, mas você paga os provedores direto em dólar | Sim — um valor fixo mensal em R$, créditos previsíveis |
| Relatório pronto pra apresentar ao cliente final? | Não — tem visualizador web local, mas sem PDF, sem marca própria, e sem compartilhar fora de quem rodou o comando. | Sim — PDF exportável, com sua marca no plano Enterprise |
| É independente dos provedores que compara? | Desde 2026, pertence à OpenAI — levanta dúvida sobre neutralidade ao comparar modelos de concorrentes (Claude, Gemini) | Não somos donos de nenhum modelo — comparação 100% neutra entre todos os provedores |
O PromptFoo é uma ferramenta open-source excelente pra quem já programa e quer rodar testes via CLI. O OtimizaIA existe pra quem quer o mesmo tipo de comparação sem escrever código.
Planos para agências que levam custo a sério
Escolha o plano — o custo real de cada execução já está incluso, sem surpresa na fatura.
* Os créditos são renovados a cada ciclo de faturamento mensal e não são cumulativos para o mês seguinte.
* O volume de testes estimado varia conforme o tamanho do prompt e os provedores escolhidos (modelos premium como GPT-4o e Claude Sonnet 5 consomem mais créditos por execução).
Como funcionam os créditos
- O que é um crédito?
- 1 crédito = R$0,001 de custo real cobrado pelo provedor do modelo.
- O que consome crédito?
- O custo real de cada execução — depende do prompt, da resposta, de qual modelo você escolheu, de quantos modelos comparou de uma vez e, se você definiu uma regra de verificação, do modelo-juiz que avalia a resposta (também tem custo próprio).
- O que acontece quando o crédito acaba?
- Novas execuções ficam bloqueadas até o próximo ciclo mensal ou uma recarga avulsa.
- O saldo acumula?
- Não — os créditos do plano resetam a cada ciclo. Créditos avulsos comprados não vencem.
- Tem recarga avulsa?
- Sim — pacotes de créditos extras, comprados uma vez, sem assinatura.
Compatível com os principais provedores e LLMs do mercado
Testes em paralelo entre OpenAI, Anthropic, Google, Meta e mais — tudo numa única comparação.
- GPT-4o
- GPT-4o mini
- GPT-5.4
- GPT-OSS 120B
- GPT-OSS 20B
- Claude Opus 5
- Claude Sonnet 5
- Claude Haiku 4.5

- Gemini Pro
- Gemini Flash Lite
- Gemini 3.8 Flash
- Llama 3.3 70B
- Llama 3.1 8B
- DeepSeek V4 Pro
- DeepSeek V3.2
- Mistral Medium 3.5
- Mistral Small 3.2
Confiança e transparência
O OtimizaIA usa o OpenRouter como camada de acesso aos modelos — seu prompt e os arquivos anexados são enviados ao OpenRouter e ao provedor do modelo escolhido (OpenAI, Anthropic, Google etc.) só durante a execução do teste, exatamente como se você chamasse a API do provedor diretamente. Disponibilidade e custo dependem do OpenRouter e de cada provedor. Recomendamos não enviar dados de clientes sem anonimizar quando o teste não precisar do dado real.